AIに任せる前にすべきこと。
いい加減、治験実施計画書・統計解析計画書・マッピング定義書等の各種ドキュメントに関して、治験単位で統一された変数名・項目名・ドメイン名みたいなのを意味も含めて連携させる仕掛けがいるよなと。
例えば、RFSTDTCは、治験薬投与開始日とイコールではない。RFSTDTCが今回の治験に関しては治験薬投与開始日とかになる、というような定義の形を考える方がいい。その定義を治験実施計画書・統計解析計画書に明確に書いてほしい。
定義が雑なこの辺りをAIにぶん投げたとしても、定義が実際にあいまいなら正しいアウトプットを得られるのは運でしかない。
あと大変余談だが、AIの信頼性が高いならそもそもプログラム提出も不要じゃないのと思ってる。ただまあ、今のAIって足し算間違うのよね。。。。。。
地味にlibxml2が死にかけてるのがマズい
OSSの疲労が結構見かけられるのだが、libxml2は広範囲にダメージがある為、困ったもんだなあとは思っている。
とは言え、XML+XSLTという組み合わせはもう現代のブラウザでは求められていないというところでもある。
だからってJSONならいいのかというと、そうじゃなくて、「大容量の定義を一気に読み込ませたりするのではなく、簡便な定義と細切れにJSONでデータ送ってクライアントJavaScriptで画面を構築する」というWeb2.0型のやり方にそぐわないからそうなっているという事であって、本質的にややこしいルールで縛るのは負担が大きい。
AIを使ってどうのというのは、まあやりたくなる気持ちも分からんでもないが、微妙に誤りがあっても許容される何かであればいいのだが、有効性や安全性の証拠集めしているような治験業務にどこまで使えるかは怪しいものではある。
OLE DB 接続文字列(SASデータセットをExcelで見る為、SAS Provider for OLE DBがインストール必要)のメモ。
provider="sas.LocalProvider";data source="<フォルダのパス>";
2024年になってもあんまり状況は変わってないなというところで、他プログラミング言語とかのあり方について少し。
SASだけやってると状況が見えづらいと思うので。
JavaやC#: 大規模システム開発用言語として
大体はJavaとC#が二強です。他言語で出来ないわけではないですが。Framework、Libraryが充実しており、過去資産も大きいです。
どれもバージョンの不安やメンテナンス性の不安はよく言われますが、それだけ長期間サポートするようなサービスが出ているという事でもあります。
正直、文法は似ていますし、多くの言語がこれらとの差分で把握されるという事もあります。
ウチの業界は少々いびつです、そういう意味では。
JavaScript/TypeScript: ブラウザで動くプログラミング言語から、範囲拡大
最初は画面のボタンのアクションから、サーバにHTTPでポストするとかなんとかするとかの言語だったのですが、
Web 2.0という変革の際に、「XMLHttpRequest」等、一つの画面の中で画面のパーツを呼び出す事ができるようになり、動的にデータもらってそれを使って画面に表を描いたりする、ようになっていきました。
その際に、サーバとクライアントの間でやり取りするデータの規格がJSONです。最初はXMLだったんですが(SOAP)、面倒くせえという事になったので・・・・・・REST APIはクライアントから呼び出す際の呼び出し方の標準化です。
最初の偉大なパッケージとしてはJQueryというのがあり、これでかけるのですが、それだけでは楽ではないとか色々あって、今JavaScriptのFrameworkとしてはReactとVue.jsがメジャーです。
もう一つ、JavaScriptには変数の型定義が動的に決まります。これを動的型付けというのですが(いわゆる軽量プログラミング言語は動的型付け言語が多いです)、大規模開発ではこの辺りが苦しい所があり、バグ発生原因の一つでもありました。なので、これに静的型付け言語のような型チェックを導入したのがTypeScriptになります。TypeScriptはマイクロソフトが中心に開発してオープンソース化しています。
もう一つCoffeeScriptというのもありましたが、こちらは冗長なJavaScriptの記述を短くするという目的です。
どちらも、JavaScriptのスーパーセットという位置付けで、つまり完全にJavaScriptに変換する事が可能です(逆は無理)。
で、もう一つ。
今までただクライアント側中心で話してましたが、サーバで動くJavaScriptという事で、Node.jsがあります。こちらも大事な技術。
なお、JavaScriptらしく、様々な他言語のWebフレームワークに色々なシーンで使われてたりという事があります。
Perl: 偉大な軽量プログラミング言語の先輩
流石にBASICさんはほぼ死んでいるという感じであり、その次の先輩としてPerlかなと。
なぜ偉大かというと、初期とにかくサーバに載せられて(UNIX)、Webのカウンターから何からバックエンドを支えた言語なので。今更CGIとか知らないですよね。
実は近代化改修もされているのですが、後輩に席を譲っている感じです。
Python、Ruby: Webサービス開発から軽量に何でもできる、軽量プログラミング言語
PythonやRubyは、スクリプト言語です。
ターミナルから起動し、シェルスクリプトみたいに使えるという言語という位置付けが最初でした。一応ね、なので、未だに初心者向けのトレーニングでは、このシェル起動を最初にしてたりします。
これらの状況を劇的に変えたのが、Ruby on Railsというやつで、フォルダ単位でプロジェクト、設定ファイル、なんかの階層を定義する事で、「何をどこに置く」みたいな事がハッキリ分かるようになり、複数人でのシステム開発をこういう軽量スクリプト言語でもできるというようなものになったのですが、これが偉大な発明ですね。
qiita.com
とは言え、海外でもDjangoというPython向けのそういうフレームワークは真似され、海外ではPython主流、日本でも最近はRubyそれほどでもという状況にはなってます。
しかし、日本だとRedmineというプロジェクト管理ソリューションが結構まだまだ使われていて、それがRubyです。PythonはTrac。
もう一つRoRの有名な仕掛けで汎用的に広まったのは、Action Recordという仕組みです。これもDBとプログラム内でのデータの取り扱いルールのようなものなのですが、シンプルな構成だとオブジェクトの定義・DBの定義等が一つでできるので大変楽できるというのがあります。
Active Record - Wikipedia
なお、製薬業界とかでは、間違いなくデータハンドリングとかでpandasが強いので・・・・・・大規模化する場合Daskとかもあります。
統計計算に関して、numpyやscipyありますが、これPythonの強みでもあり弱みでもあるのですが、高速化部分は別言語・別パッケージ仕様って事がよくあり、本家のnumpyやscipyはOpenBLAS、anacondaはIntel MKLとかあり、インストール時にも注意が必要です。結局LLMで動いている部分は遅いのは遅いので、どうやって高速化図るかというとそういう裏技使う感じです。
なお、マイクロソフトがOfficeに入れようとしたPythonはIronPythonっぽかったです。Pythonの.net framweork版という感じ。
C/C++: ドライバ開発とかに使われる、わりとプリミティブな言語
電子工作が好きな人とかではドライバ開発に使えるといいかもです。言語体系そのものは非常に基礎的なものがありますが、実際のハードウェアの仕様とかみないといけないなど、知識の方向性がハードに貫通していく言語でもあります。
VBA: 将来性に不安のある、しかしWindowsではとても重要かつ広範囲に使われている言語
多分、この広範囲に使われているであるとか重要とかで、マイクロソフトも当面サポートし続けるのでしょうが。
VBAは昔一度廃棄する話が出ましたが立ち消えてます。
でも、廃棄されそうなVBSの話が出てて、それが廃止されるとなるとそれにくっついているWSHどうするんだろうというね・・・・・・どうしましょうね。
現状のWindows環境での軽量開発言語としては最強の部類なのですが、製品にくっついている部分で、RubyやPythonのように脱皮できる気もしません。でもJScriptが死なないのであれば、WSHは生き続けるかもしれませんしねえ。
R: 統計解析言語としては生き残るでしょう
dplyr、tidyrというデータ加工パッケージはありますし、Apach ArrowのR向けラッパーもありますが・・・・・・
SAS: 仕掛け自体がビッグデータでもスケールするのは大きい。また開発効率も高いっちゃ高い、バージョン問題もクリア、ただまあお値段とかね。
同じ書き方でメモリが溢れにくい言語というので、万能的ではあるのです。
これ、COBOLが現代でも生き続けている理由の一つであったりもします。
COBOL脳を解説する(1) #cobol - Qiita
実のところ、Action Recordと似たような感じでシンプルに一行で一単位で考えるってのは変わんないのですが、SASもCOBOLも昔の言語はこういう感じでデータを読み取るものです。
入力用の領域、出力用の領域には一レコードずつ入り、さっさと追い出されます。実のところハードウェアのところでのリードキャッシュはまだしもライトキャッシュとかは効果出てきやすいです。実は結構並列的に処理が動いてます(読み込みと書き込みはハードウェアについてるRAMのところで勝手に処理されている)。
対抗馬としてはカラム型DBの複数ファイルへのカラムごと分割してのパラレルアクセスなのですが・・・・・・
SASUSERライブラリをWORKライブラリと一致させる事が出来る模様
以下のようなsasv9.cfgを作って、それを適用させると、SASUSERライブラリをWORKにする事が出来るようです。
-config "C:\Program Files\SASHome\SASFoundation\9.4\sasv9.cfg"
-sasuser WORK
-nosplash
-nologo
利点は、多分みんな今proc templateなんかのODSテンプレートの保存先をデフォルトのSASUSERにしているので、それをバッチ実行してもおかしな事にはならない事、
欠点は、バッチ起動とかで若干遅くなる(デフォルトのプロフィールを毎回コピーするから)、プロフィールに設定が仕込めない事、です。
sasv9.cfgは、起動時にパラメータで与える、あるいは、起動時のカレントディレクトリ扱いのフォルダに置いておくとかでそこのファイルが読み込まれます。
※Windowsのショートカットでは、cfgファイルを固定で読み込ませているので工夫が必要、起動時のカレントディレクトリが何になっているかとかもありますので・・・・・・バッチファイルとかで起動するようにやると出来ますよ
実のところ、別に「C:\Program Files\SASHome\SASFoundation\9.4\sasv9.cfg」のcfgファイルを書き換えなくても、ちょっとした修正cfg作り、起動を考慮すれば簡単に自分オリジナルの設定で動かせます。
次世代技術として、HTTP/3とかは知っておいた方がいいです。
そして、443のUDPのポートを開けよう!
ちなみに、BOXでもHTTP/3対応しているようです。どのくらい早くなるかはサーバの仕様にもよりますが。
SMB over QUICとかも出て来てますし、そろそろ試してもいいんじゃなかろうかと思うんですよね。
文字列検出の際に気をつけて
時々やってしまいますが。Tipsというよりは、パズルみたいなもんです。
間違い
文字列変数VISITで、中に「Period 1 Day 1」「Period 1 Day 5」なんかが含まれてます。
この時、「Day 1」の場合にフラグを立てたいと考えて、以下のようにプログラムを書きました。
data TEST ;
  length VISIT $15 ;
  VISIT='Period 1 Day -1' ;  output ;
  VISIT='Period 1 Day 1' ;  output ;
  VISIT='Period 1 Day 5' ;  output ;
  VISIT='Period 1 Day 10' ;  output ;
  VISIT='Period 2 Day -1' ;  output ;
  VISIT='Period 2 Day 1' ;  output ;
  VISIT='Period 2 Day 5' ;  output ;
run ;

data RESULT ;
  set TEST ;
  length FL $1 ;

  if index(VISIT, 'Day 1') then FL='Y' ;
  else FL='' ;
run ;
結果は以下の通りになります。
| OBS | VISIT | FL |
|---|---|---|
| 1 | Period 1 Day -1 | |
| 2 | Period 1 Day 1 | Y |
| 3 | Period 1 Day 5 | |
| 4 | Period 1 Day 10 | Y |
| 5 | Period 2 Day -1 | |
| 6 | Period 2 Day 1 | Y |
| 7 | Period 2 Day 5 |
見れば一目瞭然なのですが、「Day 10」にもフラグが立ってしまいました。
簡単な改良(部分的正解)
data RESULT ;
  set TEST ;
  length FL $1 ;

  if index(VISIT, 'Day 1 ') then FL='Y' ;
  else FL='' ;
run ;
「Day 1」の後ろに半角スペースを入れる事で、「Day 1」だけにフラグを立て、「Day 10」にはフラグを立てないようにできます。
| OBS | VISIT | FL |
|---|---|---|
| 1 | Period 1 Day -1 | |
| 2 | Period 1 Day 1 | Y |
| 3 | Period 1 Day 5 | |
| 4 | Period 1 Day 10 | |
| 5 | Period 2 Day -1 | |
| 6 | Period 2 Day 1 | Y |
| 7 | Period 2 Day 5 |
簡単な改良では考慮不足な事
上記のテストデータにはまだ入れてないのでわかりづらいのですが、実はこのコードには欠陥はあります(実務上は問題にならない事が多いですが)。
data TEST ;
  length VISIT $15 ;
  VISIT='Period 1 Day -1' ;  output ;
  VISIT='Period 1 Day 1' ;  output ;
  VISIT='Period 1 Day 5' ;  output ;
  VISIT='Period 1 Day 10' ;  output ;
  VISIT='Period 2 Day -1' ;  output ;
  VISIT='Period 2 Day 1' ;  output ;
  VISIT='Period 2 Day 5' ;  output ;
  VISIT='Period 2B Day 1' ;  output ;
run ;

data RESULT ;
  set TEST ;
  length FL $1 ;

  if index(VISIT, 'Day 1') then FL='Y' ;
  else FL='' ;
run ;
| OBS | VISIT | FL |
|---|---|---|
| 1 | Period 1 Day -1 | |
| 2 | Period 1 Day 1 | Y |
| 3 | Period 1 Day 5 | |
| 4 | Period 1 Day 10 | |
| 5 | Period 2 Day -1 | |
| 6 | Period 2 Day 1 | Y |
| 7 | Period 2 Day 5 | |
| 8 | Period 2B Day 1 |
最後に追加した「Period 2B Day 1」は、VISITのlengthギリギリまで埋められている為、末尾半角スペース入りの「Day 1 」ではうまく引っかかりません。
我々普段の業務では「十分に文字列変数の長さを取る」ので、ほぼ正解なのですが、実際増えてきてギリギリまで文字列使うようになった場合なんかではダメです。
一応、正答
じゃあ、格納文字列のlengthによって場合分けするか、とか思いがちなのですが。
一か所改良するだけで簡単に対応できます。
data TEST ;
  length VISIT $15 ;
  VISIT='Period 1 Day -1' ;  output ;
  VISIT='Period 1 Day 1' ;  output ;
  VISIT='Period 1 Day 5' ;  output ;
  VISIT='Period 1 Day 10' ;  output ;
  VISIT='Period 2 Day -1' ;  output ;
  VISIT='Period 2 Day 1' ;  output ;
  VISIT='Period 2 Day 5' ;  output ;
  VISIT='Period 2B Day 1' ;  output ;
run ;

data RESULT ;
  set TEST ;
  length FL $1 ;

  if index(VISIT || ' ', 'Day 1 ') then FL='Y' ;
  else FL='' ;
run ;
| OBS | VISIT | FL |
|---|---|---|
| 1 | Period 1 Day -1 | |
| 2 | Period 1 Day 1 | Y |
| 3 | Period 1 Day 5 | |
| 4 | Period 1 Day 10 | |
| 5 | Period 2 Day -1 | |
| 6 | Period 2 Day 1 | Y |
| 7 | Period 2 Day 5 | |
| 8 | Period 2B Day 1 | Y |
元々のVISIT内の文字列に半角スペースを追加する事で、ギリギリまで格納しているケースでも対応する事が出来ました。
SAS Viyaはまだ製薬業界では使いにくそう
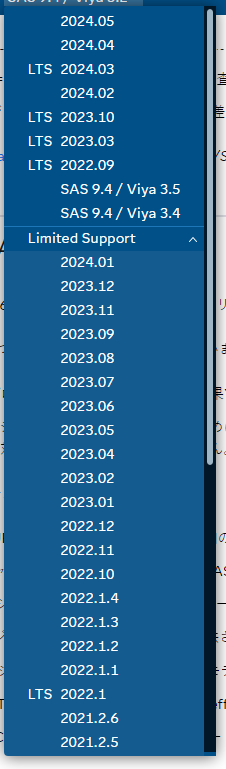
Viyaは、アップデートに継続的更新ベースのいわゆるStable版(ショートタームサポート)と、LTS版があります。
support.sas.com
Stable版は毎月アップデート出ます。最低三ヶ月ごとにアップデートする必要があります。
LTS版は半年に1回出ます。最低二年ごとにアップデートする必要があります。
厳密には、現行バージョン以外に三世代までの過去バージョンもサポートはしますという感じです。
他に、脆弱性対応の為の緊急アップデートも出ます。
あと、Viya、クラウドというかKubernetes プラットフォームに載せる事が出来るのですが、そこのバージョンについてはOSのバージョンみたいなもんで、一部限定サポートになったりします。この辺りがねえ、悩ましいんですよね。
- 顧客とCROでの環境差異をあわせるにはバージョン一致が必要で、活動が長い場合には厳しい
- ウチ等の活動はこういう製品の最新機能にはまず触れないので、バージョンアップがただ疲弊する事がある
- ただ、バージョンアップの経験が薄いとバージョンアップ時の不具合対応の経験が積めずパッチ当て不具合とかないかの検証環境構築をしないとかパッチ当てる前にバックアップ取らねえとか有り得ん事してくれる事が多い
- サポート切れギリギリにアップデートを計画するケースが多く、アップデートで業務止めるケースも多い
- ログにライセンス切れ警告が出るのは、もう契約が切れてるんで
- 日本のゆっくりした決済時間をあんまり考慮してくれてないっぽいです(二ヶ月くらい猶予はあるんですが)
- 多くの場合、システム更新は頑張るところでも五年という意識が古くはあり、このスケジュールで動けるようなリソースが情報システム部門になかったりする
ちなみに、SaaSで提供受ける場合には、勝手にバージョン上がります。
もう少し情報システム部門がしっかりしていれば使っていけるとは思うのですが、そこが一番厳しい。
Visual Studio CodeのSAS公式のExtentionのやつ動かしたいが、WinSASサーバにSSHを入れ込むのがちょっと出来るかなあ。
VS Code SAS programming extension. SAS Visual Studio Marketplace. sas-vscode-extension repository on sassoftware GitHub. Available for SAS Viya.
これ見ていると、「SAS 9.4 Remote (using SSH)」これうまいこと使ったら多分追加ライセンス費用無しでいけるのだけど、
WindowsだとPuTTYとかで、やはりやり方も紹介されている。この辺りを多少確認しながら現在のに落とし込めればいいと思うんだが。
https://support.sas.com/content/dam/SAS/support/en/technical-papers/configuring-ssh-client-software.pdf
今だとOpenSSHも考えられるかも。
learn.microsoft.com
しかしこれLinterではなく、実際にリモートでSASを動かすとかそんな仕組みなんだよなあ・・・・・・
実行時のシステムオプションがちょっと気になる。もしかしたらDMS周りのオプションが怪しいかも。結局その辺りが・・・・・・
SAS以外での、日付・日時の取り扱いを少しまとめておく
R言語
参考:
9 日付型データ | 疫学のための R ハンドブック
Rによるデータ解析のための前処理 - Appendix D — コラム: 日付・時間の書式
https://multivariate-statistics.com/2022/01/04/r-programming-date-time/
Rの日時データ #2 - 文字列⇔日時オブジェクトの変換
Baseパッケージにあるのは、DateクラスとDate-timeクラス(POSIXctクラスとPOSIXltクラスの総称)
両方とも、1970年1月1日、あるいは1970年1月1日0時0分をゼロとするPOSIXタイプらしい。ちなみにSASはここが1960年ベースなので注意。
chaos-kiyono.hatenablog.com
こんな事象があったらしい。ごめん、多分直らないのだが。
Timeのみのクラスはないようだ。
Python
参考:
Pythonで日付から曜日・月を数値・文字列で取得 | note.nkmk.me
PythonでISO 8601形式の文字列と日時datetimeを相互変換 | note.nkmk.me
標準であるdatetimeライブラリを導入して使用可能なのはdatetime/date/time。
ISO形式もある。
他言語での注意点
標準であるか、あるいは代替フォーマットがあるかというのもチェックした方がいい。
また、日付型と日時型が簡単な計算式では構成されていなかったりするのも注意。
未設定の場合、最小の想定で値が補完されるのが普通なので(日時は原則切り捨て処理、Nullを設定出来ないのが普通)、その辺りの差異注意。
また、タイムゾーンに関してケースバイケースで補完の仕方が違うので、その辺りも注意が必要。
JSONのファイルサイズを小さくするのにあるいくつかの話を。
minimizedする
JSONでは改行不要、スペース不要の為、その辺りを削ると結構サイズ減ります。これを圧縮と呼ぶ場合あります。
ファイルをzip圧縮する
一応ベタな方法なので、まあまあそのまま。
カラム指向の表現形式という事にして、重複記述を削るような事する
SDTMは正規化という概念に反逆を起こしていて無駄にデータが大きい訳ですが、多分カラム指向とかぶっこめば、可読性とかだいぶ気にしなくなり、削っていけるのでは。
カラム指向のDBは、内部的にはこんな感じでデータを持っています。
| ID | ID_AETERM |
| 1 | @1 |
| 2 | @2 |
| 3 | @3 |
| 4 | @4 |
| 5 | @5 |
| ID_AETERM | AETERM |
| @1 | 発熱 |
| @2 | ALT上昇 |
| @3 | 心不全 |
| @4 | : |
| @5 | : |
ID_AETERMが外部キーのようなもので、全部、入力値は別途管理されるようなイメージです。
Oracleでも、可変長文字列の場合、実のところこんな感じです。可変長文字列で定義すると、テーブルにはポインタが置かれ、別テーブルで管理されている文字列格納場所に内容が書かれ、ポインタ経由して文字列取ってきます。それの徹底みたいなのがカラム指向のDBです。
このAETERMの場合、実はカラム指向DBだとイマイチ恩恵に預かれないのですが(むしろ遅い・容量が大きい)、以下のようなAEOUTのケースだとだいぶ違います。
| ID | ID_AEOUT |
| 1 | @1 |
| 2 | @2 |
| 3 | @1 |
| 4 | @1 |
| 5 | @1 |
| ID_AEOUT | AEOUT |
| @1 | 回復 |
| @2 | 死亡 |
データ容量が小さくなりそうな気がするかと思います。また、例えば回復の文字が含まれるとかを検索する場合、後ろのテーブルで含まれる@~を検出して該当する@1がどのレコードに該当するかを検索すればいいだけなので、レコードが増えれば増えるほど有利になるとかもわかるかと思います。
なお、カラム指向DBだとこの指向を意識したクエリを作る必要が出てくるのも分かるとは思います。
余談:通信過程で圧縮を効かせる
データ転送なんで、HTTPのところで圧縮効かせます。当局の電子申請システムに、名前ど忘れしましたがツール使われてたりしましたが、あれはHTTP通信ではないはず。そういうレベルで実装する感じです。
モダンブラウザではほぼ圧縮に対応しているので、特に気にせず使ってたりするでしょうね。
en.wikipedia.org
HTTP/3が2022年にRFC化したようで、高校の同級生がやってるのでちょくちょくチェックはしているのですがあまりにレイヤーが違うので見てるだけでした。が、まあ、今後、電子申請のポート開放だとかの必要性が、無くなっていくはず(とか言いながら何十年も維持されそう)
HTTPが全てを飲み込む(前編)~HTTPの2層構造と、HTTP Semanticsとは何か? - Publickey
ただし、このHTTP/3、現在最新版のブラウザだと既に対応・利用もだいぶ普及しており、動画とか見る時には使われているかもしれません。
gigazine.net
なので、結構この辺り、最新バージョンへアップデートとかを検討された方がいいシステムが沢山出てくるような気がします。
Dataset-JSONの、その先
メタデータのもたせ方が、JSON Schema派生じゃなくなるかもしれない。
いわゆるテーブルのスキーマ定義の話なんですが、現状ではJSON SchemaよりもProtocol Buffersなどのプログラム言語の定義に近い形の一般化になりつつあります。
この辺りで一般情報引っ張るには、インタフェース記述言語・IDLとかシリアライズ形式とか言ってもいいかもです。
JSON Schemaは少し過去のものになりつつあります。
スキーマ定義と、治験での関連文書についての情報を、そろそろ分離する試みがあってもいいかも。
要は、メタデータ定義として全部入りなdefine.xmlを解体した方がいいかということです。
例えばTrialの情報とか、全部入りにする必要ないですよね?
入れて定義されるからややこしい&定義がグダリやすいんで、ちょっとどうにかした方がいいと思ってます。
プログラムで使う部分と、それ以外分けたいやん?
いい加減圧縮形式を。
圧縮すんのが当たり前の世の中で、圧縮してないのが全く意味が分かりません。
有効桁数は変数にそのまんまは格納されない(SASでもそうだし他のプログラム言語でも)。
いわゆる有効桁数について、いい加減DMが解析に聞くのは止めた方がいい。
てか、DMがEDCからの出力で有効桁数をどうやって格納するか設計してるはずなんだがという話・・・・・・
SASフォーマットで有効桁数を表す場合、設計時に有効桁数定義をしているという事にはなる。
まあ、入力ルールを設定していないのがそもそも駄目(収集するデータに合わせて有効桁数を設定する、というのは、治験では本来行われないもの)なのだが。有効桁数を定義するのは、CRF設計に属するものである。これを面倒だから・理解できないからと、設計しないのがまず間違っている。
過去のCDMS等では、SIGNIFICANT DIGITの変数を持ったり、なんとかOracleの定義で頑張ろうとはしていたが、
そもそも有効桁数というのは、臨床検査の測定装置依存だったりするので、検査項目毎に有効桁数のテーブルもある方がいい。バイタルサインや心電図も同様に考えるべきである。有効桁数は、測定誤差の表現の一種なんで、0.1刻み等とは限らないのも考えておく方がいいかと思う。
